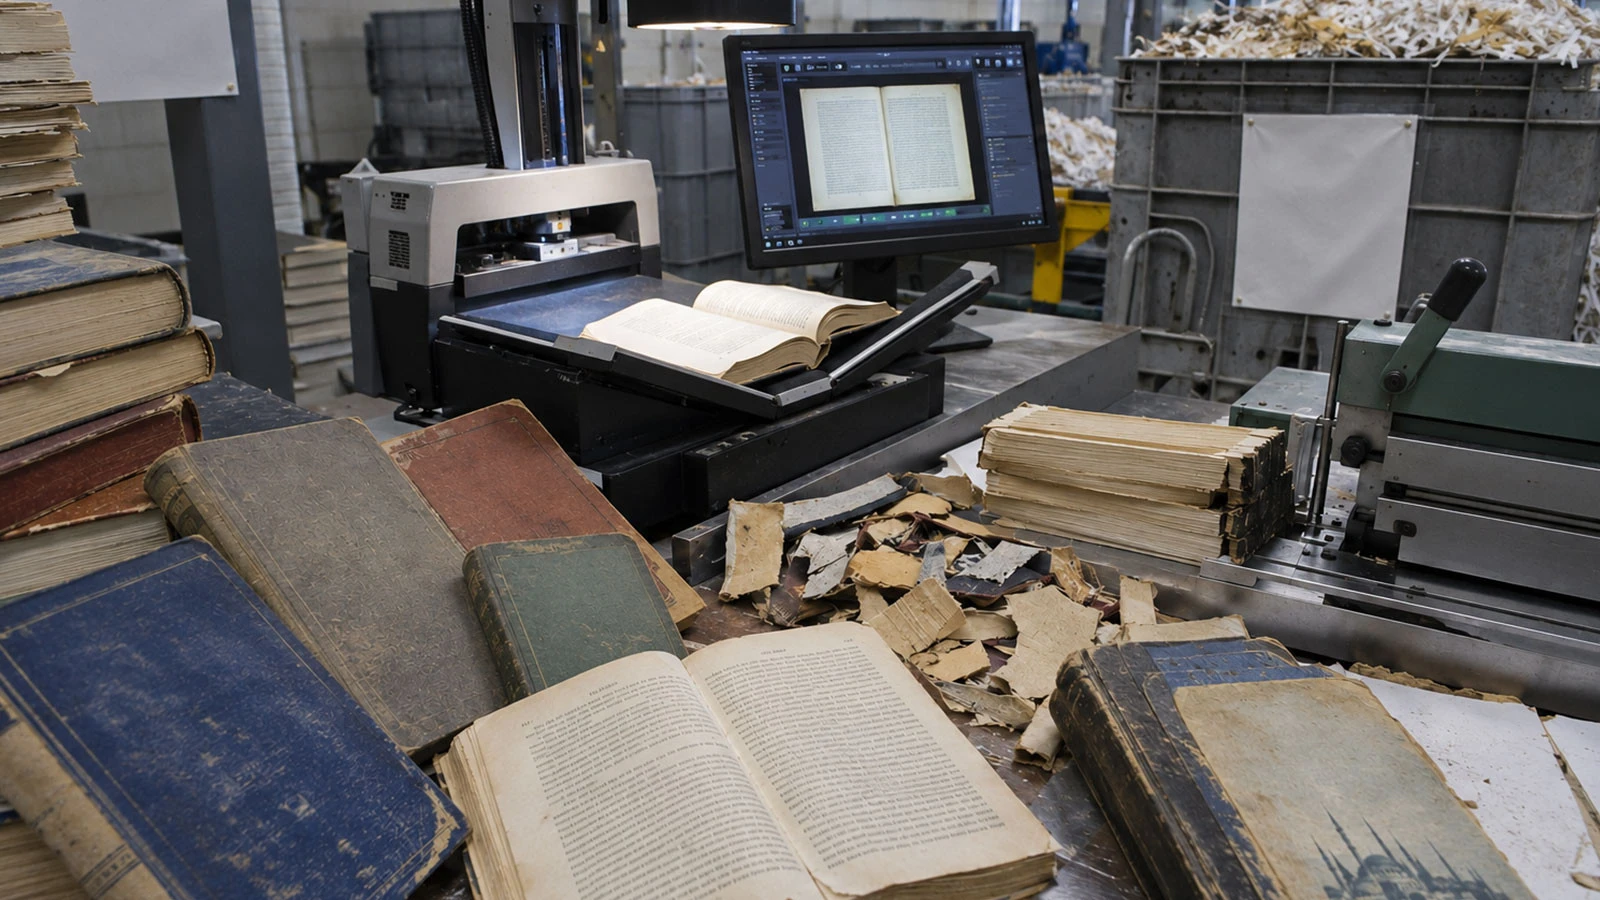
La révélation selon laquelle les sociétés d’intelligence artificielle se sont tournées vers des ouvrages imprimés non disponibles sur Internet pour développer de grands modèles de langage a suscité des réactions. Il a été démontré que certaines entreprises achètent des millions de livres, puis les séparent de leurs reliures, les numérisent avec des scanners industriels et envoient les copies physiques au recyclage. La méthode du scan destructif, appelée « destructive scanning » en anglais, a pris une nouvelle dimension, notamment avec l’augmentation de la demande d’éditions anciennes et d’ouvrages académiques.
DES MILLIONS DE LIVRES ONT ÉTÉ COUPÉS
Au centre du débat se trouve Anthropic, le développeur du système d’intelligence artificielle appelé Claude. Selon la décision du tribunal fédéral de l’État américain de Californie du 23 juin 2025, l’entreprise a acheté des millions de livres imprimés en 2024.. Les livres, pour la plupart d’occasion, ont été séparés de leurs reliures, leurs pages ont été découpées et converties en fichiers numériques. Les livres physiques ont été éliminés une fois la transaction finalisée. Dans des documents internes à l’entreprise divulgués en janvier 2026, il a été révélé que l’opération avait été réalisée sous le nom de « Projet Panama ». Selon des documents obtenus par le Washington Post, l’entreprise recherchait un prestataire de services capable de numériser entre 500 000 et 2 millions de livres en six mois. La principale raison pour laquelle cette méthode a été privilégiée était la rapidité et l’avantage en termes de coût.
COMMANDE DE 3 MILLE LIVRES
Il a également été déterminé que l’activité de collecte de livres s’étendait également à l’Europe. Une liste contenant les numéros ISBN d’environ 3 000 livres différents a été envoyée à un libraire d’occasion à Haarlem, aux Pays-Bas, par une société basée à Singapour appelée 2077AI. Certains bouquinistes anglais ont déclaré avoir reçu des commandes de centaines de livres en quelques mois.
ACCORD DE DROIT D’AUTEUR
Dans le procès pour droits d’auteur intenté contre Anthropic, il a été déterminé que la société avait obtenu plus de 7 millions d’exemplaires de livres numériques provenant de sources piratées. La société est parvenue à un règlement de 1,5 milliard de dollars pour résoudre les réclamations liées aux droits d’auteur couvrant environ 500 000 œuvres. L’accord, finalisé en juillet 2026, prévoyait un paiement brut d’environ 3 mille dollars par œuvre. Cependant, ce règlement concernait les réclamations en matière de droits d’auteur concernant les copies numériques piratées, et non le déchiquetage de livres physiques.
RÉCLAMATION D’ARCHIVES EN Türkiye
On prétend que des maisons d’édition universitaires de Turquie se sont vu offrir des sommes élevées en échange du transfert de leurs archives de 17 000 à 20 000 livres à des sociétés d’intelligence artificielle. Alors que la loi n° 5846 sur les œuvres intellectuelles et artistiques en vigueur en Turquie protège les droits des auteurs, les débats juridiques se poursuivent concernant les données utilisées dans l’enseignement de l’intelligence artificielle. Le projet de loi numéro 2/3634, soumis à la Grande Assemblée nationale turque le 8 avril 2026, vise à actualiser la loi sur le droit d’auteur à l’ère de l’intelligence artificielle.
IL EST ENTRE LES MAINS DES ENTREPRISES
L’un des risques les plus importants soulignés par les experts est que les livres ne sont pas de simples textes. La reliure d’une œuvre ancienne, son papier, les notes manuscrites dessus, les différences d’impression et les signes des propriétaires précédents peuvent également avoir une valeur historique. Le déchiquetage des livres peut entraîner la perte permanente de ces informations insuffisamment documentées. Le géostratège-chercheur Dr. Ahmet Uslu a déclaré : « La raison pour laquelle les entreprises d’intelligence artificielle se tournent particulièrement vers les vieux livres est d’accéder à des informations originales qui ne sont pas disponibles sur Internet. « Les études universitaires, la recherche sur l’histoire locale et les ouvrages en édition limitée sont considérés comme des ressources précieuses pour la formation de modèles d’intelligence artificielle. » dit-il.
DES PRÉCAUTIONS DOIVENT ÊTRE PRISES
L’écrivaine littéraire Sema Soykan exprime sa réaction face à la destruction de livres imprimés à des fins de formation à l’intelligence artificielle par les mots suivants : « Ne pas pouvoir accéder aux livres anciens est un grand problème pour les écrivains et les chercheurs, mais c’est bien plus inquiétant pour notre histoire et notre culture. Par conséquent, nous devons écrire davantage, lire davantage, laisser notre marque dans l’histoire et protéger les anciens.
